← 返回 AI大模型从0到1——理论与实操
C4-03 向量数据库
回顾RAG两阶段
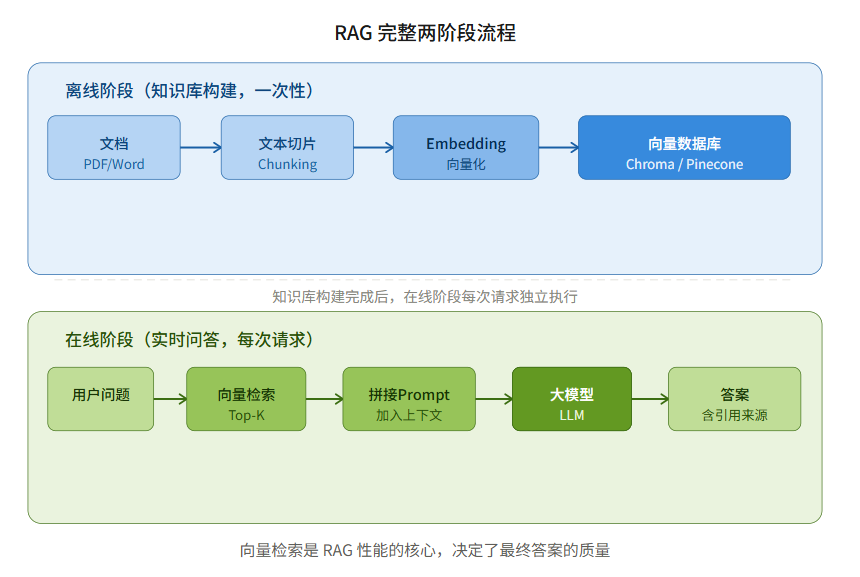
向量数据库
如果文档有几百万条,每次都逐一计算余弦距离效率太低。向量数据库专门为此设计了高效的索引和检索算法(如 HNSW、IVF)。
主流向量数据库对比:
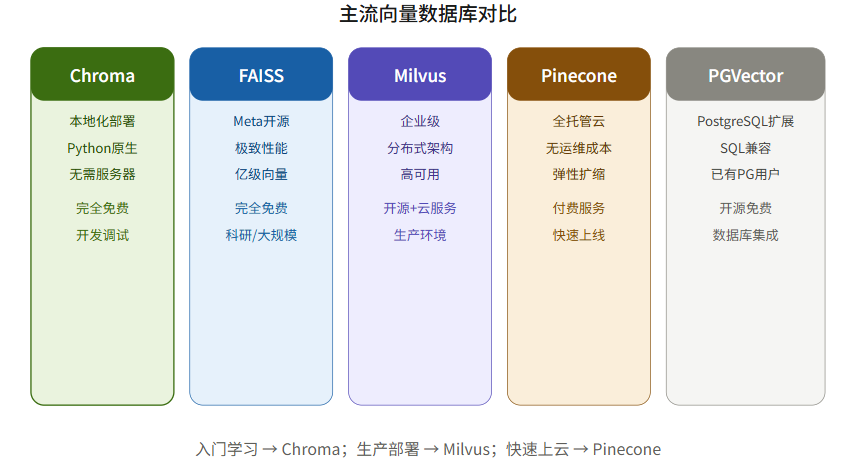
| 数据库 | 特点 | 适合场景 |
|---|---|---|
| Chroma | 本地轻量,易上手 | 学习、开发原型 |
| FAISS | Meta 开源,速度快 | 高性能本地检索 |
| Milvus | 开源,生产级 | 大规模生产环境 |
| Pinecone | 云端托管 | 无需运维的云服务 |
| PGVector | PostgreSQL 插件 | 已有 PG 的项目 |
关键概念澄清:
-
向量数据库本身不生成向量——向量是由 Embedding 模型产生的
-
向量数据库和关系型数据库是互补的,不是替代关系;向量数据库可以通过metadata进行数据过滤。
Python
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | |
输出:
C:\Users\nianh\.cache\chroma\onnx_models\all-MiniLM-L6-v2\onnx.tar.gz: 100%|█| 79.3
[['人工智能是计算机科学的一个分支', '机器学习是人工智能的子集']]
📌 Chroma向量数据库内置了embedding模型all-MiniLM-L6-v2(来自 Sentence Transformers),开箱即用,不过中文效果较差,生产环境要换好一点的embedding模型,见注释代码
🍞 数据库
所有的数据库的核心能力就是数据的增、删、改、查,向量数据库也不例外